 诚络营销
在不同AI里搜公司,答案为什么不一样?聊聊多平台监测
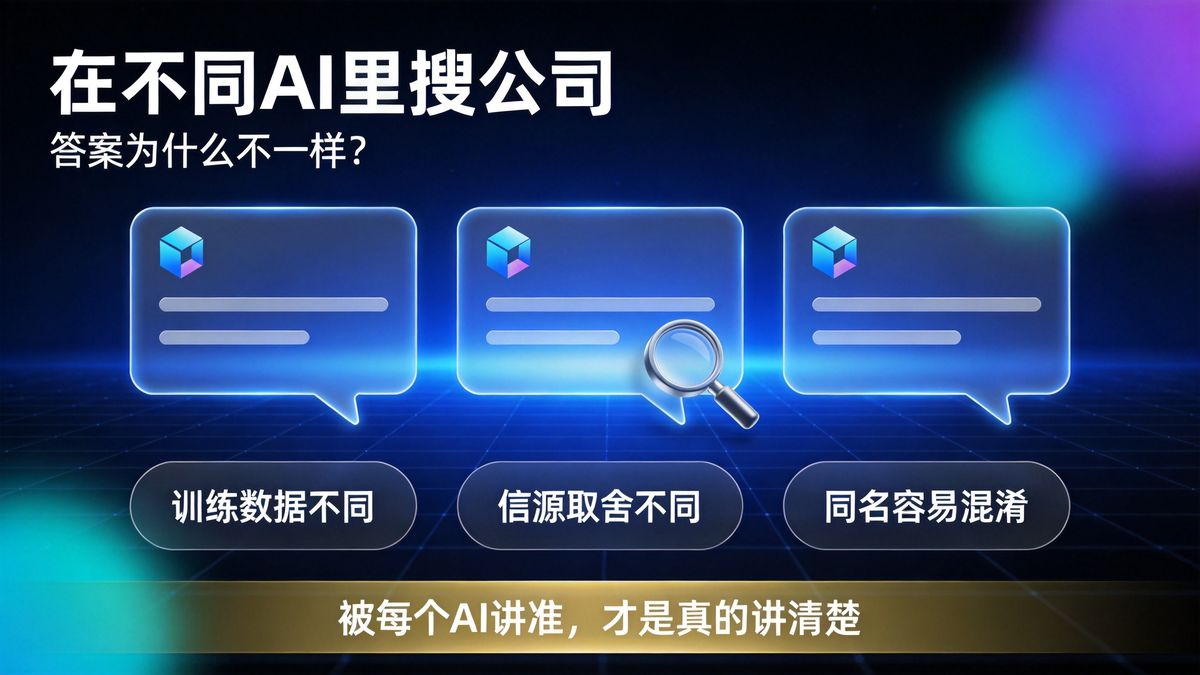
不少企业第一次认真做GEO(生成式引擎优化)时,都会做同一个动作:把自家公司名挨个拿到豆包、DeepSeek、文心一言、通义、Kimi里去问一遍。问完往往有点懵——明明是同一家公司,每个AI给的说法居然都不一样。有的能准确说清业务,有的张冠李戴,还有的干脆把你和同名公司混成了一家。
这不是哪一个AI"出错"了,而是它们本来就不是同一个"大脑"。
为什么不同AI的答案会不一样
理解这件事,要回到AI回答是怎么生成的。豆包、DeepSeek、文心一言等产品背后是不同厂商训练的大模型,它们之间至少有三个差别。
第一,训练数据不同。各家模型抓取和采信的网页、百科、新闻、问答内容范围不一样,更新时间也不同。你公司的信息被A收录了,不代表B也收录了。
第二,理解和排序逻辑不同。面对一堆互相矛盾或同名的信息,每个模型判断"哪条更可信"的方式不一样,于是引用的信源就不同。
第三,联网检索的来源不同。即便是实时联网回答,各家接入的搜索源、对结果的取舍也有差异,同一句话问下去,调取的素材可能完全不同。
常见的三种不一致
在实际帮企业排查的过程中,差异通常表现为下面三种情况。
一是"有和无"的差别。有的AI能介绍你,有的只回一句"暂未找到相关公开信息"。这往往意味着在后者更看重的那类信源上,你几乎没有内容。
二是"夸大或偏差"的差别。比如把"服务过百家企业"说成行业领先、把局部业务讲成主营业务。这通常是AI在信息不足时,根据零散素材做了过度推断。
三是"张冠李戴"的差别。把你和同名、近名公司混在一起,业务、地区、成立时间全错。这种在常见字号、常见行业名的企业身上尤其容易发生。
多平台监测具体怎么做
既然差异客观存在,只盯一个AI去优化显然不够。比较稳妥的做法是把监测做成一件常规的事。
先确定一份平台清单。把目标客户真正会用的AI列出来,国内通常以豆包、DeepSeek、文心一言、通义、Kimi、腾讯元宝、夸克为主,按自己的客户习惯取舍,不必贪多。
再固定一套问法。不要每次随口问。建议统一用几类问题:公司是做什么的、靠不靠谱、主打产品或服务、和某类同行比有什么区别、在某个地区有没有这家公司。固定问法,后面才好对比变化。
记录基线并定期复查。第一次问完,把每个平台的回答截图或抄录存档,作为基线;之后每隔一段时间用同样的问题再问一遍,看描述有没有变准确、错误有没有被纠正。
发现错误就针对性补信源。哪个平台描述有偏差,就去补齐它更看重的那类权威、结构化、口径统一的内容,而不是笼统地"多发点东西"。
把监测当成长期动作
需要说明的是,AI对品牌的描述不会因为你改了一次资料就立刻同步,模型重新抓取、重新采信都需要时间。所以多平台监测的意义,不是查一次求个安心,而是持续知道"在每个重要的AI眼里,你到底是个什么形象",再一点点把偏差修回来。
被一个AI讲清楚不难,难的是在客户可能用到的每一个AI里,都被讲得准确、一致。诚络营销长期关注GEO与品牌在AI搜索中的表现,也会持续分享多平台监测和内容优化的实操思路。